
使用wkpdftohtml将爬取到的网页生成PDF时,使用示例代码
import requests
from bs4 import BeautifulSoup
import pdfkit
url = ‘http://www.liaoxuefeng.com/wiki/‘       ‘001434446689867b27157e896e74d51a89c25cc8b43bdb3000‘
response = requests.get(url)
bsObj = BeautifulSoup(response.content, ‘xml‘)
body = bsObj.findAll(class_=‘x-wiki-content‘)
html = str(body)
html = html.encode(‘utf-8‘)
fp = open(‘test.html‘, ‘wb‘)
fp.write(html)
fp.close()
fp = open(‘test.pdf‘, ‘wb‘)
fp.close()
pdfkit.from_file(‘test.html‘, ‘test.pdf‘)
出现警告
Warning: A finished ResourceObject received a loading progress signal. This might be an indication of an iframe taking too long to load
并且没有得到预想中的PDF文件。(代码块访问的是廖雪峰的js教程网站)
将beautifulsoup中的解析器换成"lxml"或“html.parser则能够生成预期的PDF文件
阅读BeautifulSoup的文档
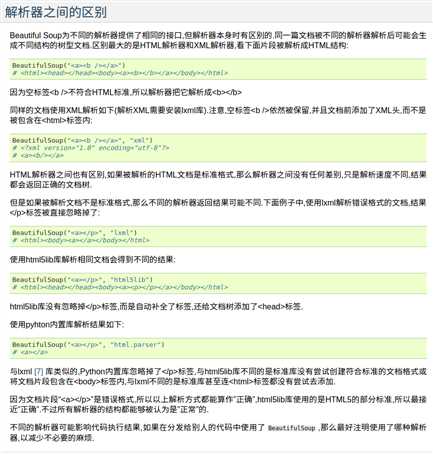
原因是xml的解析方式将网页中的hr标签补全并使其并入前一个div标签,所以html文件中出现了大量的其他内容?致使生成失败?(目前没学html,所以不是很了解,如有其他好的见解望指正)
解决办法是将解析器换成‘lxml’,或者‘html.parser’,‘html5lib‘
不过生成的test.PDF不是中文,而我爬取的整个教程是中文,暂时推测是因为测试的内容太少,BeautifulSoup自动检测的时候识别错误,详细请看
未完待续
原文:http://www.cnblogs.com/ZackBee/p/6659849.html