
import requests
from bs4 import BeautifulSoup

url=‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘

res=requests.get(url)
res.encoding=‘utf-8‘

soup=BeautifulSoup(res.text,‘html.parser‘)

for news in soup.select(‘li‘):
    if len(news.select(‘.news-list-title‘))>0:
        title=news.select(‘.news-list-title‘)[0].text
        time=news.select(‘.news-list-info‘)[0].contents[0].text
        url=news.select(‘a‘)[0][‘href‘]
        thumb=news.select(‘.news-list-thumb‘)[0].contents[0]
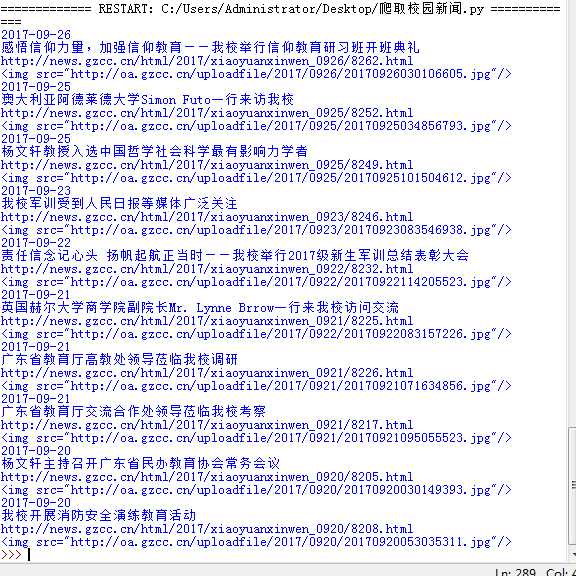
        print(time)
        print(title)
        print(url)
        print(thumb)
import requests
from bs4 import BeautifulSoup
jq=‘http://www.gamersky.com/pcgame/‘
res = requests.get(jq)
res.encoding=‘utf-8‘
soup = BeautifulSoup(res.text,‘html.parser‘)

for news in soup.select(‘li‘):
    if len(news.select(‘a‘))>0:
        title=news.select(‘a‘)[0].text
        url=news.select(‘a‘)[0][‘href‘]
        #time=news.select(‘span‘)[0].contents[0].text
        #print(time,title,url)
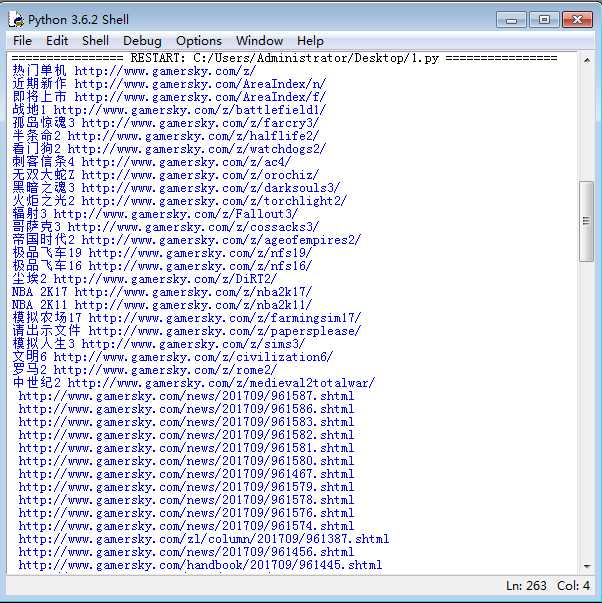
        print(title,url)
用requests库和BeautifulSoup4库爬取新闻列表
原文:http://www.cnblogs.com/yxhjss/p/7607107.html