
import jieba

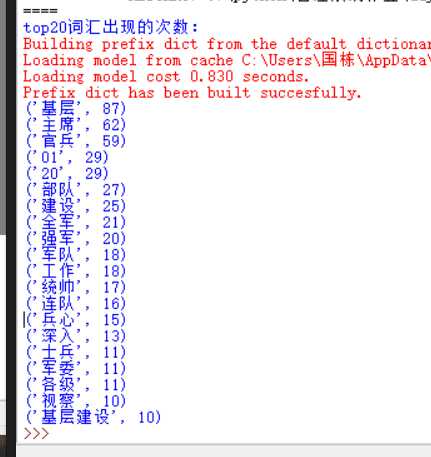
print(‘top20词汇出现的次数:‘)

#读入文本文件
txt=open(‘G:\wgd.txt‘,‘r‘,encoding=‘utf-8‘).read()


#清除无意义符号

for i in ‘,。!、 \n “” ;‘:
    txt=txt.replace(i,‘‘)
#词汇的列表

d={}
words=jieba.cut(txt)
keys=set(words)

#单词汇计数元祖的列表
for i in keys:
    if len(i)>1:
        d[i]=txt.count(i)
        a=list(d.items())


a.sort(key=lambda x:x[1],reverse=True)#排序

#输出前20频率词汇
for i in range(20):
    print(a[i])
原文:http://www.cnblogs.com/wgd0069/p/7612787.html