下载一长篇中文文章。
从文件读取待分析文本。
news = open(‘gzccnews.txt‘,‘r‘,encoding = ‘utf-8‘)
安装与使用jieba进行中文分词。
pip install jieba
import jieba
list(jieba.lcut(news))
生成词频统计
排序
排除语法型词汇,代词、冠词、连词
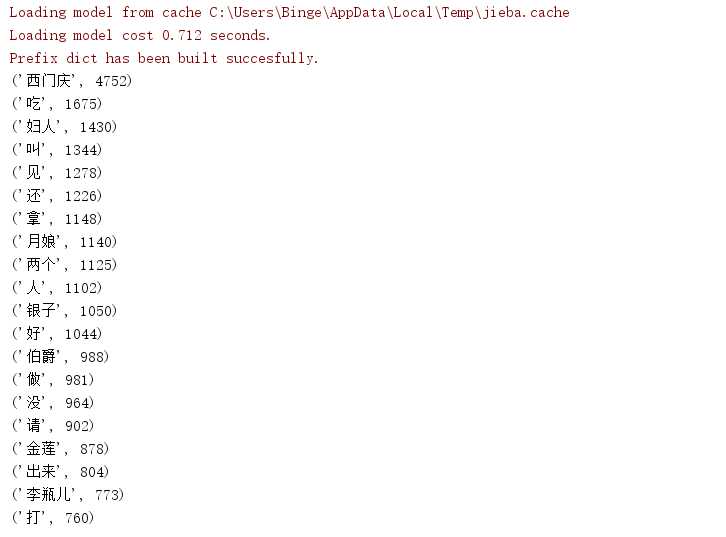
输出词频最大TOP20
将代码与运行结果截图发布在博客上。
import jieba
text = open(‘jinpingmei.txt‘,encoding=‘utf-8‘).read()
textList = list(jieba.lcut(text))
useless = {‘,‘,‘。‘,‘ ‘,‘了‘,‘:‘,‘“‘,‘”‘,‘的‘,‘\n‘,‘他‘,‘道‘,‘你‘,‘我‘,‘在‘,‘?‘,           ‘来‘,‘说‘,‘去‘,‘与‘,‘不‘,‘是‘,‘、‘,‘也‘,‘又‘,‘!‘,‘着‘,‘儿‘,‘这‘,‘到‘,‘就‘,            ‘把‘,‘那‘,‘有‘,‘上‘,‘都‘,‘便‘,‘和‘,‘说道‘,‘等‘,‘只‘,‘要‘,‘小‘,‘罢‘,‘问‘,‘那里‘,           ‘怎‘,‘一个‘,}

textDic = {}
for i in textList:
    textDic[i] = textDic.get(i,0)+1

for d in useless:
    del textDic[d]

textLs = list(textDic.items())
textLs.sort(key=lambda e:e[1],reverse=True)
for s in range(20):
    print(textLs[s])