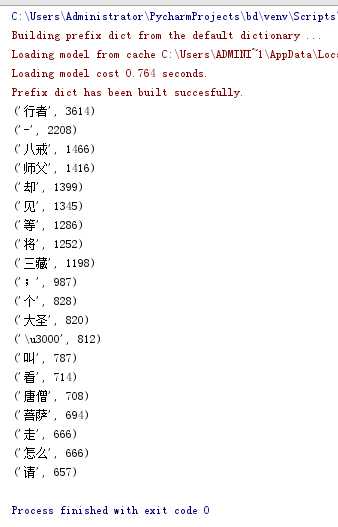
import jieba


fo=open(‘aaa.txt‘,‘r‘,encoding = ‘utf-8‘)

text=fo.read()
text2=list(jieba.lcut(text))

sign={‘你‘,‘ ‘,‘我‘,‘我们‘, ‘他‘, ‘他们‘, ‘我的‘, ‘他的‘, ‘你的‘, ‘呀‘, ‘和‘, ‘是‘,‘,‘,‘。‘,‘:‘,‘“‘,‘”‘,‘的‘,‘啊‘,‘?‘,‘在‘,‘了‘,           ‘说‘,‘去‘,‘与‘,‘不‘,‘是‘,‘、‘,‘也‘,‘又‘,‘!‘,‘着‘,‘儿‘,‘这‘,‘到‘,‘就‘, ‘\n‘,‘(‘,‘)‘,‘那‘,‘有‘,‘上‘,‘便‘,‘和‘,‘只‘,‘要‘,‘小‘,‘罢‘,‘那里‘,           ‘…‘,‘一个‘,‘?‘,‘人‘,‘把‘,‘被‘,‘她‘,‘都‘,‘道‘,‘好‘,‘还‘,‘’‘,‘‘‘,‘呢‘,‘来‘,‘得‘,‘你们‘,‘才‘,‘们‘}

text3={}
for i in text2:
    text3[i]=text3.get(i,0)+1

for i in sign:
    if i in text3:
        del text3[i]

text4 =sorted(text3.items(),key=lambda x:x[1],reverse=True)
for i in range(20):
    print(text4[i])