
爬取豆瓣top250前100部电影
 1 # -*-coding=UTF-8 -*-
 2
 3 import requests
 4 from bs4 import BeautifulSoup
 5
 6     headers = {‘User-Agent‘:‘Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36‘,
 7                ‘Host‘: ‘movie.douban.com‘}
 8     movie_list = {}
 9
10     for i in range(0,4):
11         link = ‘https://movie.douban.com/top250?start=‘+ str(i*25)+ ‘&filter=‘
12         r = requests.get(link,headers=headers,timeout=10)
13         print(str(i+1),‘states:‘,r.status_code)
14         # print(r.text)
15         soup = BeautifulSoup(r.text,"lxml")
16         div_list = soup.find_all(‘div‘,class_="info")
17
18         for each in div_list:
19             name =  each.div.a.span.text.strip()
20             info =  each.p.text.strip()
21
22             movie_list[name]=info
23
24     return movie_list
25
26 movies = get_movies()
27
28 with open(‘douban.txt‘,‘w‘,encoding=‘utf-8‘) as f:
29     for  k in movies:
30         f.write(str(‘\n‘+k+‘ :: ‘+ movies[k] +‘\n\n‘+‘-------------------------‘+‘\n\n‘))
31     f.close()
32     print(‘Finished!!!‘)
输出结果截图:
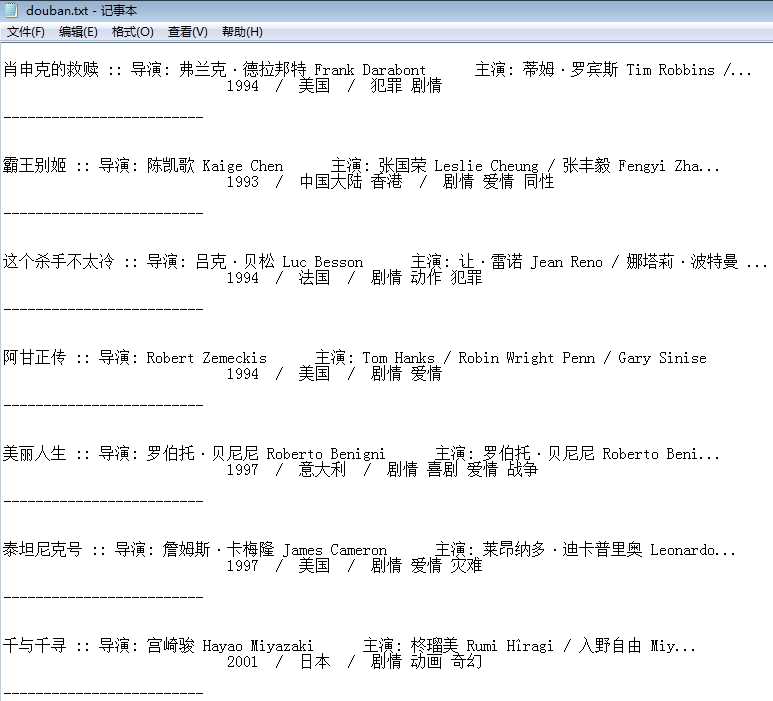
我的第一个python爬虫:爬取豆瓣top250前100部电影
原文:https://www.cnblogs.com/cooper-73/p/9881772.html