
import requests


def getHTMLtext(url):
    try:
        r = requests.request(‘get‘ ,url )
        r.raise_for_status()
        r.encoding = r.apparent_encoding
        return r.text
    except:
        return "出现异常"
url = "https://item.jd.com/100005477055.html"
print(getHTMLtext(url))
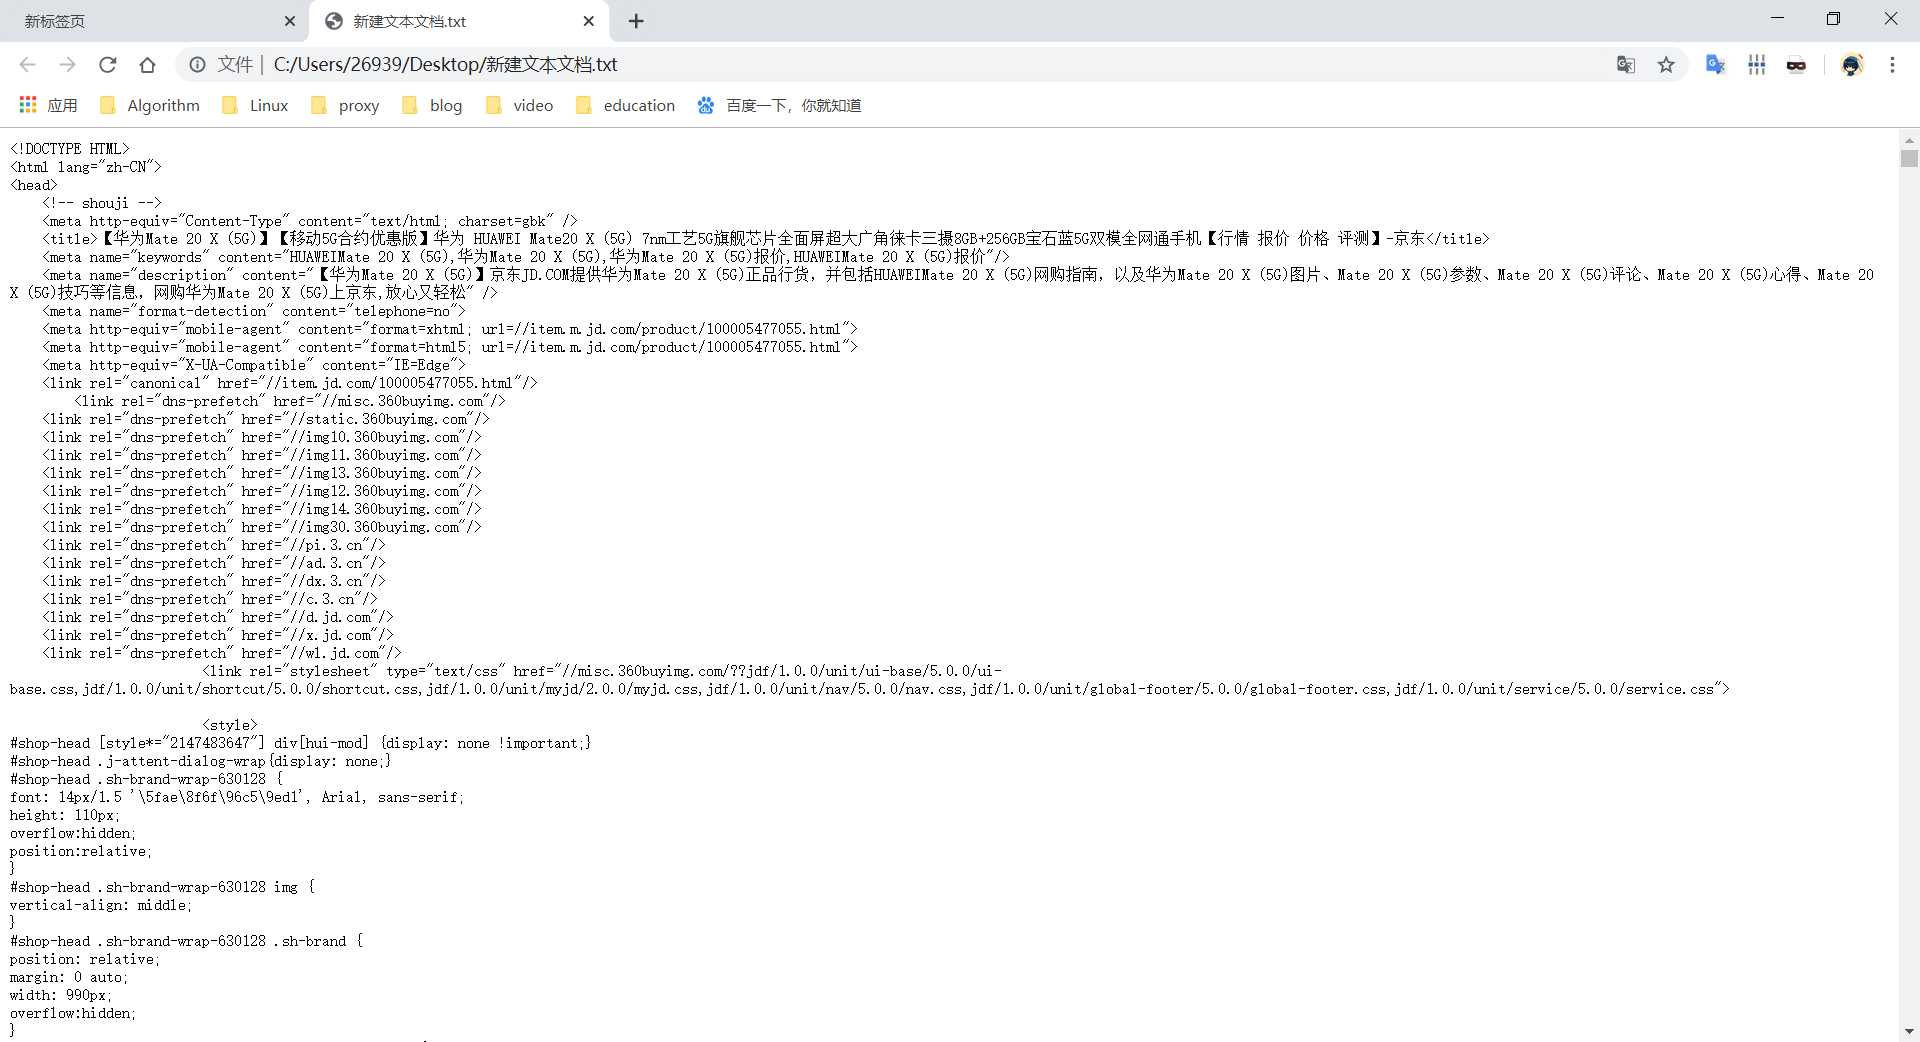
结果如下:
import requests

url = ‘https://www.amazon.cn/dp/B00RY59GJ0?ref_=Oct_DLandingSV2_PC_e9324a46_0&smid=A2EDK7H33M5FFG‘

r = requests.request(‘get‘,url)

print(r.status_code)

header = {‘user-agent‘: ‘Mozilla/5.0‘}

r = requests.request(‘get‘,url,headers = header)

print(r.headers)

print(r.status_code)

print(r.text)
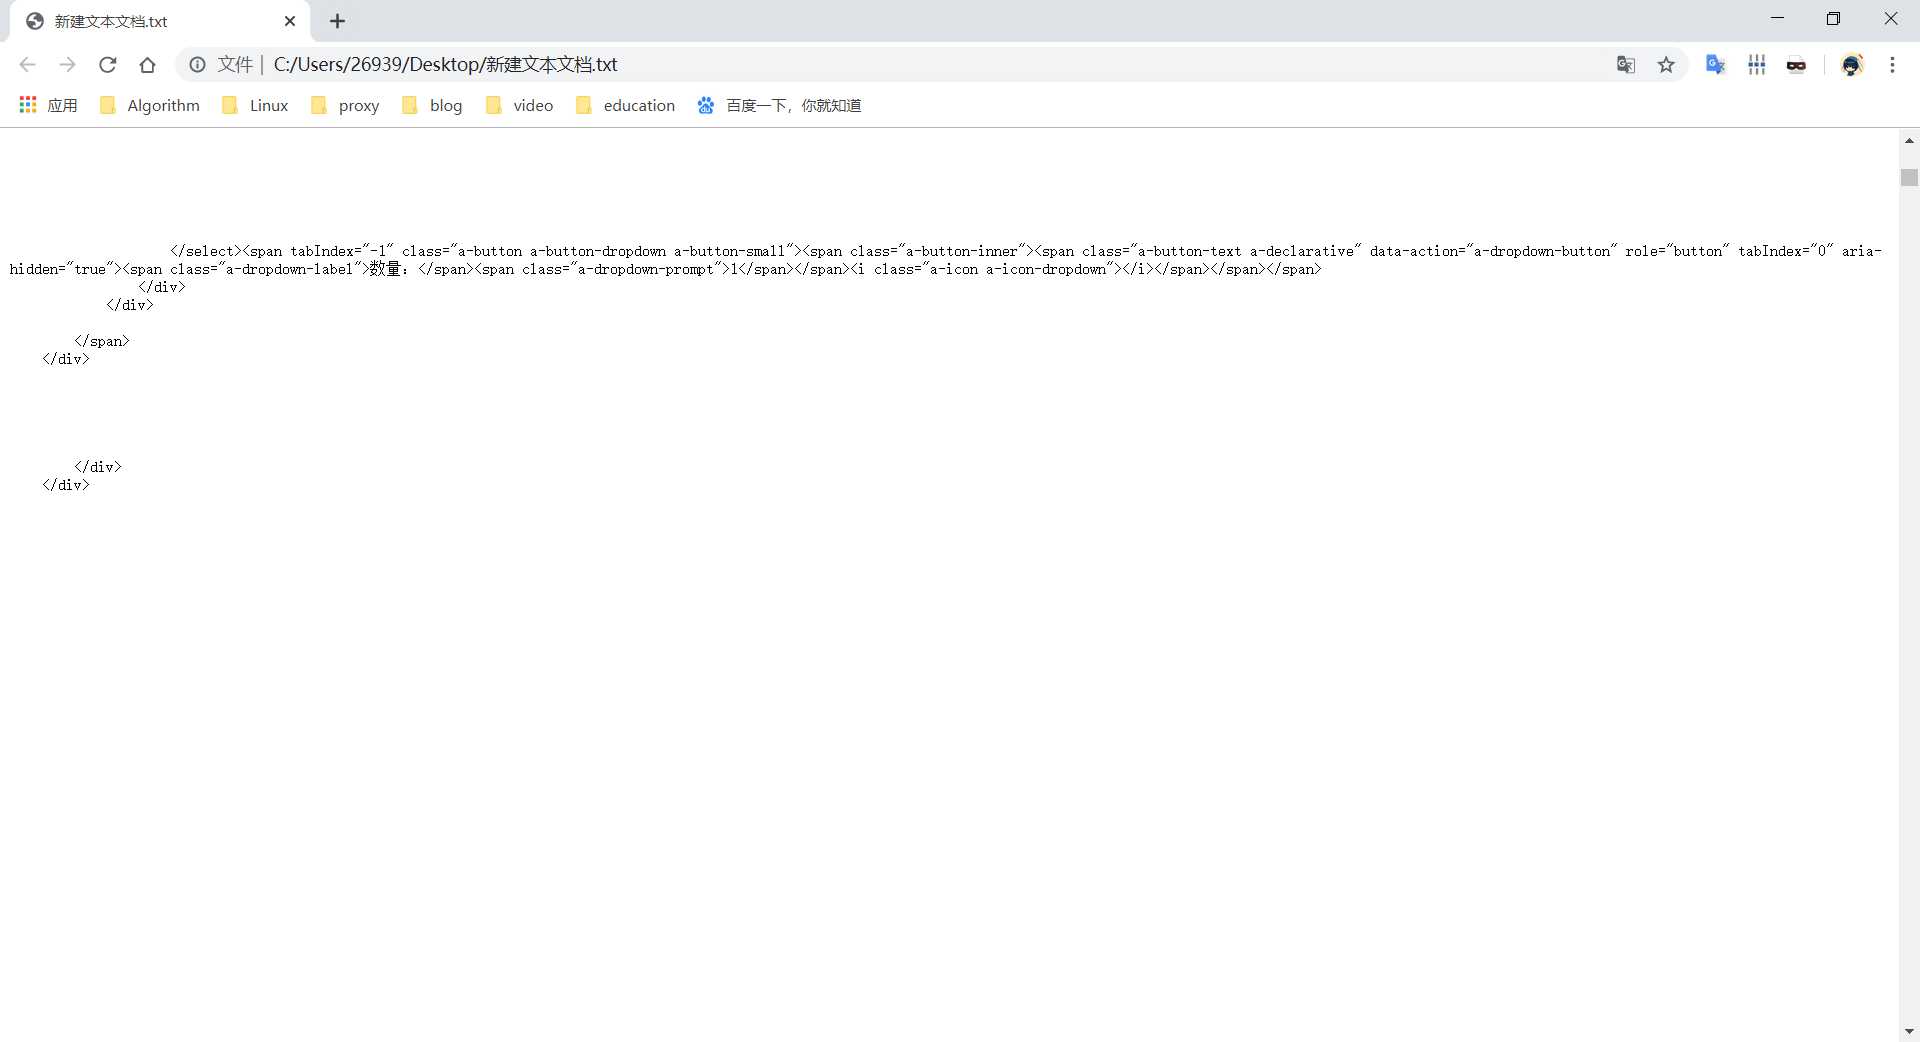
亚马逊的官网是反爬虫的,因此我们要将user-agent更换
原文:https://www.cnblogs.com/Nlifea/p/11875649.html